视频转 AI 提示词怎么做:从参考画面到可用指令的完整示范
用红丝带海边镜头演示观察记录、文生视频与图生视频提示词,并通过排错表修改运镜、动作和画面稳定性问题。
视频转提示词,先要弄清参考画面发生了什么,再决定新生成的镜头保留什么。“电影感、情绪强、高质量”并没有告诉模型,画面中的主体究竟要做什么。
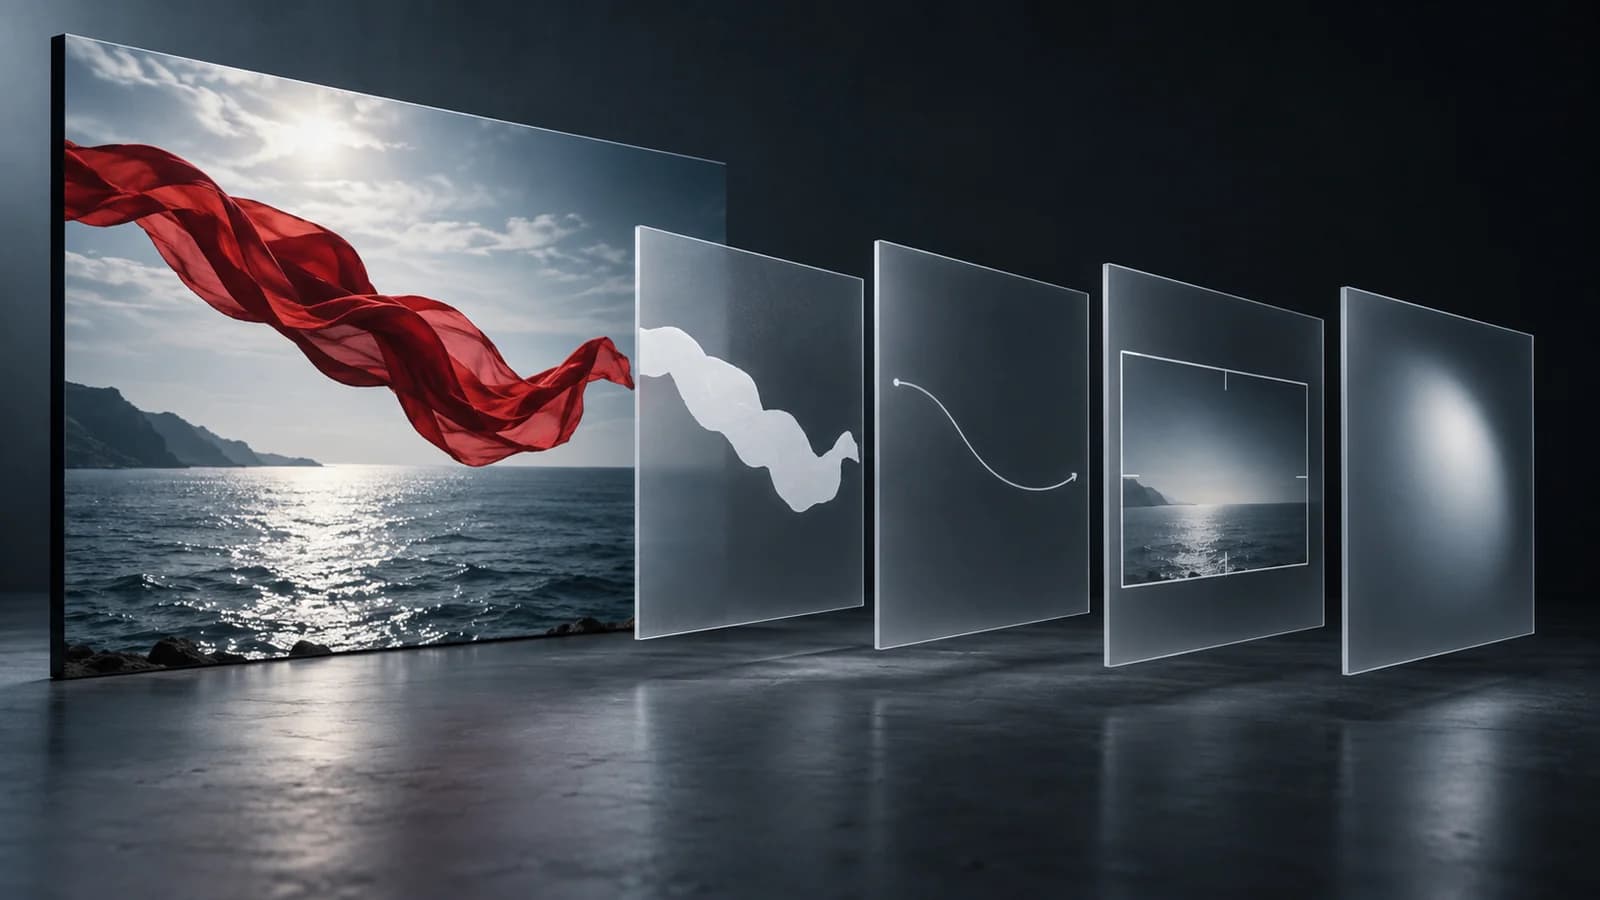
这篇用原创练习演示:系在码头栏杆上的红丝带,被海风吹起又落下。以下提示词仍是草稿,尚未用模型实测。
1. 先填一张简单的观察表
| 问题 | 这个练习的镜头设定 |
|---|---|
| 主体是什么? | 一根系在旧木栏杆上的红丝带。 |
| 发生什么动作? | 松散的一端被风吹起,转动后落下。 |
| 在哪里? | 海边码头,背景能看见海面。 |
| 镜头怎样拍? | 固定近景,看清绳结和丝带末端。 |
| 光线怎样? | 阴天早晨的柔和光线。 |
| 哪个细节不能变? | 绳结始终系在同一处栏杆上。 |
对照真实视频记录时,不确定的细节不要当事实写下。没有必要猜它使用了什么品牌的摄影机。
2. 先把一个动作写清楚
含糊的初稿可能是:
海边美丽又有情绪的红丝带,史诗级运镜,电影感,惊人的细节。
改成较清楚的文生视频草稿:
近景,一根红丝带系在海边码头的旧木栏杆上。松散的一端被海风轻轻吹起,转动一次,随后落回木栏杆旁。绳结保持固定。阴天早晨的柔和光线,背景是海面,固定镜头。
现在有了主体、动作和构图,没有把码头全景、特写、暴风雨和日落同时塞进一个短镜头。
3. 已经有参考图时,换一种写法
如果起始图片已经确定丝带、栏杆、光线和构图,可以尝试更短的图生视频草稿:
丝带松散的一端被微风吹起,转动一次,随后落回栏杆旁。绳结保持固定,镜头保持不动。
Runway 的 Gen-4 提示词指南针对该模型建议使用简单动作描述、正向表达和逐步迭代。这是特定模型的建议,不是所有视频工具的统一语法。
使用时查看目标模型的文档。时长、参考图和画面比例,有时应该在界面参数中设置,而不是写在提示词里。
4. 把剪辑计划与单次生成分开
假设参考片段依次有码头全景、丝带特写和人物取走丝带。先把它记为三个镜头,再按目标工具支持的方式分别生成或拍摄,最后剪辑在一起。
还原结果可以保留时间段和声音说明,方便规划。但准备粘贴到生成工具前,需要把这一条短镜头真正需要的内容取出来。时间轴对剪辑有用,不代表生成模型会精确服从逐秒指令。
5. 结果不对时,一次只改一个重点
| 看到的问题 | 可以先尝试怎样改 |
|---|---|
| 想要静止镜头,画面却在移动。 | 删除互相冲突的运镜词,明确固定镜头。 |
| 丝带从栏杆上脱落。 | 减少动作幅度,并说明绳结保持固定。 |
| 几乎没有动作。 | 明确是松散的一端在动,检查参考图是否留有运动空间。 |
| 镜头中途换了环境。 | 去掉转场,一个测试只保留一个地点。 |
| 动作对了,画面风格不对。 | 保留动作,只调整一项光线或风格描述。 |
这些是排错实验,不是必然有效的修复。把提示词、模型设置和结果一起保存,才能知道是哪一项调整产生了变化。
用 VidBreak 准备文字草稿
VidBreak 的视频转提示词功能能从有权分析的视频中还原主体、动作、时间、镜头和声音,选定范围最长 10 分钟。它输出 AI 视频提示词文字,视频生成在你选择的工具中完成。
先对照视频检查动作是否准确,再按目标模型调整。它不能保证恢复视频原作者没有公开的原始提示词。可以查看三种格式的成果实例,或阅读提示词成果使用说明。
常见问题
每条视频提示词都要写声音吗? 目标模型支持所需声音时再加入,否则把声音作为后期说明,或单独制作。
提示词越长越准确吗? 不一定。增加能消除歧义的细节即可。互相冲突的运镜和过多转场,反而让目标不清楚。
十分钟还原结果能整段粘贴进生成器吗? 先把它当作制作计划,再按目标模型支持的镜头或片段长度拆开,逐条调整。